
Yapay zekanın gelişmesiyle birlikte hayatımıza yalnızca yeni araçlar ve uygulamalar değil, bu teknolojilerin nasıl çalıştığını anlamamızı sağlayan teknik kavramlar da giriyor. Context windows, token, prompt, inference, attention, KV cache, embedding, RAG ve fine-tuning gibi terimlerle giderek daha sık karşılaşıyoruz. İlk bakışta yalnızca geliştiricileri ilgilendiriyor gibi görünen bu kavramlar, aslında kullandığımız yapay zekâ modellerinin yeteneklerini, sınırlarını ve onlardan neler bekleyebileceğimizi anlamak açısından da önem taşımaktadır.
Bir modelin ne kadar büyük olduğu veya ne kadar hızlı yanıt verdiği önemli. Peki, üzerinde çalıştığımız projenin ayrıntılarını ne ölçüde takip edebiliyor? Uzun bir konuşmanın başında belirttiğimiz kuralları neden bazen gözden kaçırıyor? Yüzlerce sayfalık bir belgeyi kabul etmesi, belgedeki bütün bilgileri doğru biçimde değerlendirebildiği anlamına mı geliyor?
Bu soruları ele alırken karşımıza çıkan temel kavramlardan biri context window (bağlam penceresi). Ancak bu kavramı yalnızca “Modele ne kadar uzun metin gönderebiliriz?” sorusuyla açıklamak yeterli değil. Asıl önemli olan, sunulan bilginin nasıl kullanıldığı, konuşma geçmişinin nasıl yönetildiği ve daha fazla içeriğin yanıt kalitesine ne ölçüde katkı sağladığı.
128K’lık bir context window, modelin çalışma alanının genişliğini gösterir; bu alandaki bilgiyi ne kadar başarılı kullandığını değil. Bu nedenle örneğin; RAG için model seçerken, daha fazla içeriği aynı anda sunabilmeyi daha güvenilir yanıt üretmekle eş tutmamak gerekir. Belgelerin context window içine sığması, soruyla ilgili bilginin doğru bulunacağını veya modelin bu bilgiden doğru bir sonuç çıkaracağını tek başına göstermez.
Burada iki ayrı aşamayı değerlendirmek gerekiyor: Soruyla ilgili bilgilerin doğru bulunup getirilmesi (retrieval) ve üretilen yanıtın bu bilgilere dayandırılması (grounding). Daha geniş bir context window, eksik veya hatalı bilgi getirme sürecini kendiliğinden düzeltmez; modelin sunulan kaynaklara sadık kalmasını da garanti etmez.
Dolayısıyla değerlendirmeyi “Ne kadar içerik sığıyor?” sorusuyla sınırlamamak gerekir. En az bunun kadar önemli bir başka soru da şudur: “Doğru bilgi getiriliyor mu ve model bu bilgiyi doğru kullanıyor mu?”
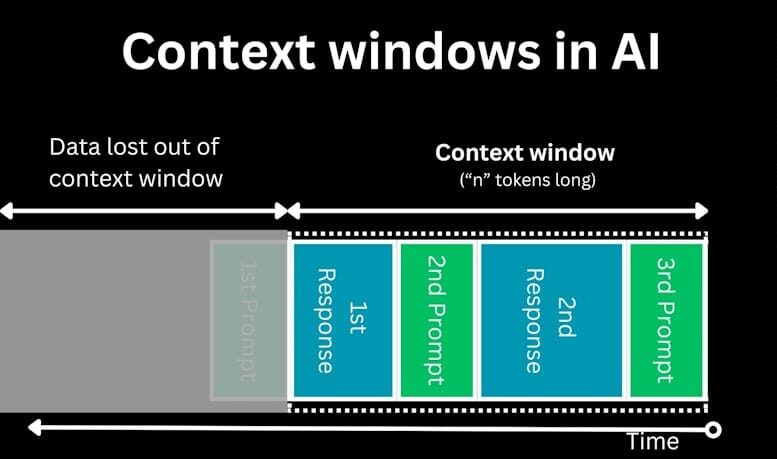
Bu makalede context window kavramını yalnızca bir token sınırı olarak değil; doğruluk, performans, maliyet ve uygulama tasarımı açısından ele alacağız. Kalıcı hafızadan nasıl ayrıldığını, RAG mimarilerindeki yerini ve model seçerken kapasitenin ötesinde nelere bakmamız gerektiğini inceleyeceğiz.
İçindekiler
Context window nedir?
Context window, dil modelinin yanıt üretirken değerlendirebildiği bağlamın token cinsinden kapasitesi olarak tanımlayabiliriz. Context windows yalnızca kullanıcının son mesajından oluşmamaktadır. Sistem talimatları, isteğe dahil edilen sohbet geçmişleri, belgeler, araç tanımları ve araçlardan gelen sonuçlar da aynı çalışma alanını paylaşabilirler.
Yaygın kullanılan birçok modelde, üretilecek yanıt da toplam bağlam bütçesi içinde değerlendirilir.
Context window kavramını anlamak için bir çalışma masası benzetmesi kullanabiliriz. Masanız ne kadar büyükse aynı anda o kadar çok belgeyi önünüzde açık tutabilirsiniz. Ancak masanın büyüklüğü, belgelerin tamamını doğru yorumlayacağınızı veya aralarındaki her ilişkiyi fark edeceğinizi garanti etmemektedir.
Yazılım dünyasında bazen context window tarafının RAM’e benzetildiğini de duymuşsunuzdur. Bu benzetme aslında, geçici çalışma alanını anlatmak için açısında faydalıdır. Ancak unutmamak gerekir ki, context window verilerin adreslerinden kusursuz biçimde okunabildiği klasir bir bellek sistemi değildir. Bir bilginin bağlamda bulunması ile yanıt oluşturulurken doğru kullanılabilmesi arasında fark bulunmaktadır.
Dolasıyla bir model seçiyorsunuz, model seçimi sırasında context windows kapasitesini değerlendirirken iki ayrı soruyu sormanız gerekmektedir. Model ne kadar bilgiyi kabul ediyor ve bu bilginin ne kadarından güvenilir bir biçimde yararlanabiliyor?
Context window neden token ile ölçülür?
Context window kapasitesini doğru yorumlanması için öncelikle bu kapasitenin birimini anlamak gerekmktedir. Dil modelleri metinleri doğrudan kelime veya sayfa sayısına göre işlememektedir. Bunun yerine metin, token adı verilen birimlere ayılmaktadır. Bir token; bir kelimenin tamamını, kelimenin bir bölümünü, bir karakteri veya noktalama işaretini temsil edebilir. Bu nedenle token sayısı ile kelime sayısı kesinlikle aynı şey değildir.
Örneğin 128K context window ifadesini, “Model yaklaşık 128 bin kelimelik bir belgeyi işleyebilir” şeklinde yorumlamak doğru olmaz. Aynı metnin token sayısı kullanılan tokenizer’a, modele ve dile göre değişmektedir. İngilizce metinler için kullanılan yaklaşık kelime-token oranları, Türkçe içeriklerde aynı sonucu vermeyebilir. Teknik dokümanlardaki dosya yolları, kod parçaları ve yapılandırma ifadeleri için de gerçek token sayısını ölçmek gerekir.
Kapasite planlamasında esas alınması gereken ölçü, hedef modelin tokenizer’ı veya sağlayıcının token sayım aracıyla elde edilen değerdir.
Context window bütçesi nasıl paylaşılır?
Bir modelin context window kapasitesinin tamamı, kullanıcı belgeleri için ayrılmış boş bir alan olarak düşünmemek gerekir. Sistem talimatları, konuşma geçmişi, araç tanımları ve araçların döndürdüğü sonuçlar da bu bütçeden pay alabilir. Giriş ve çıkışı ortak pencere içinde değerlendiren modellerde, üretilecek yanıt için de yeterli alan bırakılmalıdır.
Bunu somutlaştırmak için toplam kapasitesi 128.000 token olan, giriş ve çıkışın aynı bütçeyi kullandığı varsayımsal bir model düşünelim:
| Kullanım alanı | Örnek token bütçesi |
|---|---|
| Sistem talimatları ve araç tanımları | 6.000 |
| Sohbet geçmişi ve mevcut kullanıcı isteği | 18.000 |
| Belgeler ve araç sonuçları | 80.000 |
| Yanıt üretimi için ayrılan alan | 16.000 |
| Kalan kapasite | 8.000 |
| Toplam | 128.000 |
Bu tablo, herhangi bir ürünün gerçek kullanım ölçümü değil; kapasitenin nasıl paylaşılabileceğini gösteren bir örnektir.
Burada bir başka ayrıntı daha vardır: Maksimum context window kapasitesi ile maksimum çıktı uzunluğu aynı sınır değildir. Model çok uzun bir girdiyi kabul edebilse de tek seferde üretebileceği yanıt daha kısa olabilir. Bazı akıl yürütme modellerinde kullanıcıya gösterilmeyen reasoning tokenları da ilgili bütçelere dahil edilir.
Ayrıca bütün AI modelleri aynı hesaplama yöntemini kullanmamaktadır. Bazılarında giriş ve çıkış ortak bütçeyi paylaşırken, bazılarında ayrı giriş ve çıkış sınırları bulunur. Bu nedenle örnekteki hesabı bütün modellere doğrudan uygulamak yerine, kullanılan modelin dokümantasyonundaki sınırlar esas alınmalıdır.
Context window nasıl daha verimli yönetilir?
Verimli kullanımın amacı, context window içindeki token sayısını ne pahasına olursa olsun azaltmak olmamalıdır. Amaç, görev için gerekli kanıtları korurken ilgisiz, tekrarlanan veya geçerliliğini yitirmiş içerikleri ayırmaktır.
Bu yaklaşım context engineering, yani bağlam mühendisliği olarak ele alınabilir. Prompt engineering, talimatların nasıl yazıldığına odaklanırken; context engineering talimatlarla birlikte belgelerin, araç sonuçlarının, konuşma geçmişinin ve çalışma durumunun nasıl düzenlendiğini de kapsar.
Uzun süren bir sorun giderme çalışmasında, bütün konuşmayı tek parça hâlinde taşımak yerine güncel durumu ayrıca kaydetmek yararlı bir tasarım tercihidir. Böyle bir kayıt; doğrulanmış belirtileri, yapılan işlemleri, işlem sonuçlarını ve henüz test edilmemiş ihtimalleri birbirinden ayırabilir.
Örneğin “Sorun DNS kaynaklı” şeklindeki kesin bir not ile “DNS olasılığı değerlendiriliyor; henüz doğrulanmadı” notu aynı bilgiyi taşımaz. Çalışma durumunu özetlerken yalnızca sonuçların değil, kanıt ile varsayım arasındaki ayrımın da korunması gerekir.
Araç kullanan ajanlarda bir başka yöntem, ayrıntılı içerikleri gerektiğinde yeniden erişilebilecek şekilde dışarıda tutmaktır. Dosya konumları, kısa çalışma notları ve kaynak referansları korunabilir; ilgili içerik ihtiyaç anında tekrar okunabilir. Böylece bütün araç çıktılarının sürekli aktif bağlamda kalması gerekmez.
Model seçerken context window nasıl değerlendirilmelidir?
AI Model seçimini yalnızca kapasite tablosundaki en büyük sayıya göre yapmak yerine, gerçek iş yükünü temsil eden testlerle değerlendirmek gerekmektedir. Basit bir bilgiyi bulma, farklı kaynakları birleştirme ve dolaylı ilişkilerden sonuç çıkarma görevleri aynı beceriyi ölçmez. Uzun bağlam araştırmaları, bu görevleri ayrı ayrı değerlendirmenin önemini gösterir.
Bir uygulama için aşağıdaki gibi bir değerlendirme çerçevesi kullanılabilir:
| Değerlendirme alanı | Sorulması gereken soru |
|---|---|
| Uzun bağlam doğruluğu | Girdi uzadığında doğru yanıt üretme başarısı korunuyor mu? |
| Bilginin konumu | Gerekli kanıt başta, ortada veya sonda olduğunda sonuç değişiyor mu? |
| Retrieval kalitesi | Soruyu cevaplamak için gereken içerikler gerçekten getiriliyor mu? |
| Grounding | Yanıttaki iddialar sunulan kaynaklarla destekleniyor mu? |
| Yanıtın eksiksizliği | Beklenen önemli bilgiler veya istisnalar atlanıyor mu? |
| Performans ve maliyet | Kabul edilebilir kalite, hedeflenen yük altında hangi kaynak kullanımıyla sağlanıyor? |
Bu çerçeve, uzun bağlam testlerindeki konum duyarlılığını; RAG değerlendirmelerindeki retrieval, grounding ve eksiksizlik ayrımını; çıkarım performansındaki gecikme ve kapasite ölçümlerini birlikte ele alır.
Burada amaç yalnızca bir başarı puanı üretmek değil, hata oluştuğunda bunun nereden kaynaklandığını anlayabilmektir. Gerekli belge hiç getirilmediyse retrieval süreci; belge mevcut olduğu hâlde yanlış yorumlandıysa modelin kaynak kullanımı ve context window incelenmelidir.
Sonuç: Daha büyük bir context window, tek başına daha güvenilir bir sistem değildir
Context window (bağlam penceresi), bir modelin aynı istekte ne kadar içerikle çalışabileceğini anlamamızı sağlar. Ancak bu kapasiteyi kalıcı hafıza, kusursuz hatırlama veya yüksek doğrulukla eş tutmamak gerekir.
Bu nedenle hedef, pencereyi mümkün olduğunca doldurmak değil; doğru bilgiyi seçmek, gerekli ayrıntıları korumak ve modelin bu bilgileri nasıl kullandığını ölçmek olmalıdır.
Asıl soru yalnızca “Bu modelin context window kapasitesi ne kadar?” değildir. “Bizim görevimiz için gerekli bilgiyi, ne kadar güvenilir ve hangi maliyetle kullanabiliyor?” sorusu da en az bunun kadar önemlidir.
Cengiz YILMAZ – Microsoft MVP
IndieTools – Founder
